Faire fonctionner une IA locale consiste généralement à installer sur son ordinateur un modèle de langage déjà entraîné, puis à l’utiliser sans envoyer ses conversations vers un service cloud. Pour commencer, choisissez une application adaptée à votre niveau, téléchargez un petit modèle quantifié et testez-le avant de passer à des usages plus exigeants.
Sommaire
Comprendre ce que vous installez réellement
Une IA locale n’est pas un assistant créé de zéro. Vous faites tourner un LLM, ou grand modèle de langage, sur un PC, un Mac ou une machine Linux. Ce modèle repose notamment sur l’architecture des transformers et produit du texte à partir des instructions reçues. L’application installée sur l’ordinateur sert de runtime : elle charge le modèle en mémoire, affiche une interface de discussion et propose parfois une API locale.
Vérifiez vos bases sur l’IA locale
L’intérêt principal concerne la maîtrise des flux de données. Un courrier interne, un extrait de contrat ou des notes de réunion peuvent être traités sur la machine, à condition que l’outil documentaire utilisé ne les transmette pas à un service externe. Le mode hors ligne est aussi pratique dans les transports, sur un réseau restreint ou pour éviter les quotas d’un abonnement. En contrepartie, le modèle n’a pas de recherche web par défaut et ses connaissances ne se mettent pas à jour automatiquement.
Local ne signifie pas infaillible
Un modèle local peut reformuler, résumer, classer des informations, produire du code ou extraire des éléments d’un fichier. Il peut aussi inventer une référence, mal interpréter une consigne ou répondre avec assurance à une question incertaine. Conservez donc une validation humaine pour les décisions juridiques, médicales, financières ou professionnelles sensibles. La confidentialité protège les entrées, mais elle ne garantit ni l’exactitude ni la conformité de la réponse.
Choisir l’outil selon votre manière de travailler
Le bon logiciel est celui qui réduit les difficultés lors du premier essai. Les outils suivants peuvent fonctionner sous Windows, macOS ou Linux selon leurs versions, mais leur logique d’utilisation diffère nettement.
| Outil | Profil recommandé | Atout principal | À prévoir |
|---|---|---|---|
| LM Studio | Débutant et utilisateur visuel | Interface graphique pour rechercher, télécharger et utiliser un modèle | Choisir un fichier compatible et surveiller la mémoire utilisée |
| Ollama | Développeur ou utilisateur à l’aise avec le terminal | Lancement simple de modèles et API locale pratique | Utiliser des commandes et, si besoin, ajouter une interface web |
| GPT4All | Utilisateur cherchant une prise en main directe | Approche orientée conversation et documents locaux | Vérifier les capacités documentaires du modèle retenu |
| Jan.ai | Utilisateur voulant une interface de bureau | Expérience graphique et accès à différents fournisseurs ou modèles locaux | Distinguer un modèle local d’un service distant configuré dans l’application |
Pour débuter sans terminal, LM Studio ou GPT4All sont des choix accessibles. Pour intégrer une IA dans un script, un éditeur de code ou une application interne, Ollama est souvent plus pertinent grâce à son API locale. Open WebUI peut ensuite apporter une interface web à un moteur local, tandis que llama.cpp offre davantage de contrôle aux profils techniques.
Ne confondez pas application, modèle et interface
Cette distinction évite de nombreuses erreurs. Ollama ou llama.cpp exécutent le modèle. Un modèle comme Mistral, Gemma ou Qwen fournit les capacités linguistiques. Une interface comme Open WebUI rend les échanges plus simples. Vous pouvez donc changer de modèle sans changer d’outil, ou conserver le même moteur en adoptant une autre interface. Avant tout téléchargement, consultez la page officielle de LM Studio ou celle d’Ollama pour installer la version correspondant à votre système.
Vérifier la mémoire avant de choisir le modèle
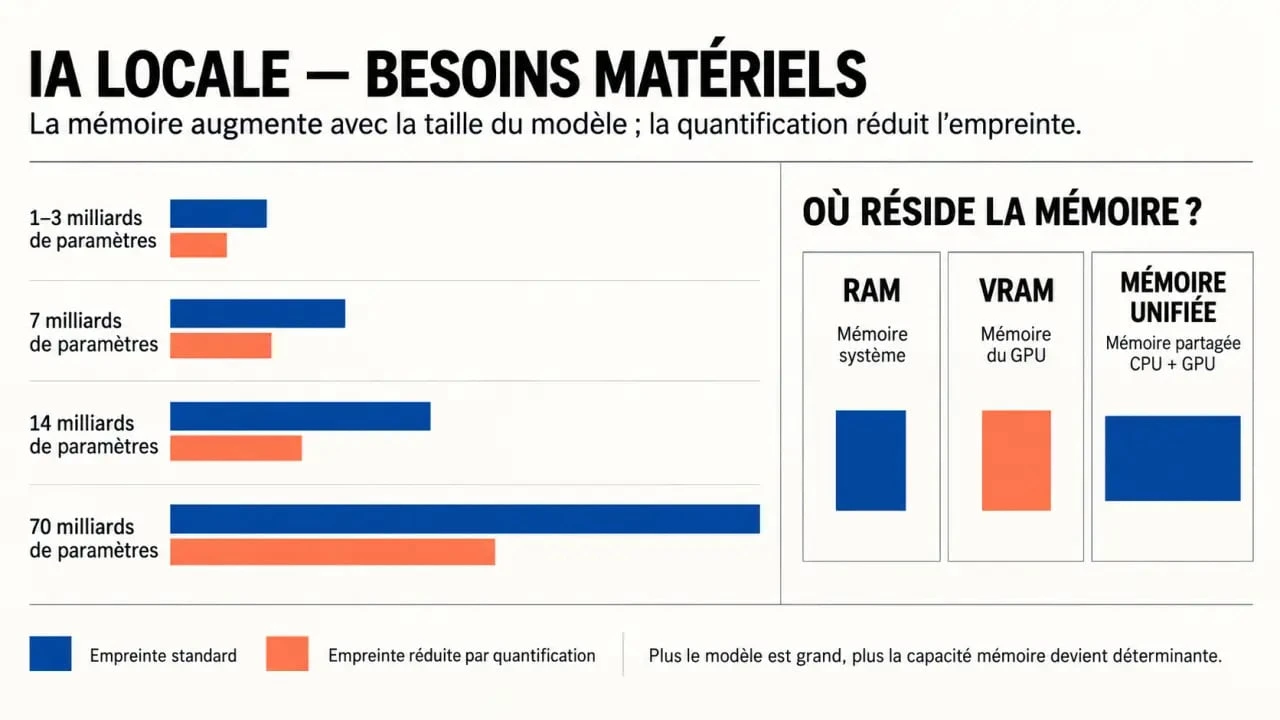
La compatibilité ne dépend pas seulement du processeur. La RAM accueille le modèle lors d’une exécution sur CPU. La VRAM de la carte graphique accélère généralement l’inférence lorsqu’elle est disponible. Sur les Mac Apple Silicon, la mémoire unifiée joue ces deux rôles. Une machine équipée de 8 Go de RAM peut lancer de petits modèles, mais 16 Go offrent une marge plus confortable pour le système et les conversations.
| Taille indicative du modèle | Usage réaliste | Repère matériel |
|---|---|---|
| 1 à 3 milliards de paramètres | Tests, reformulation courte et commandes simples | Configuration modeste, avec priorité à la légèreté |
| 7 milliards de paramètres | Discussion générale, synthèse et tâches courantes | 16 Go de RAM recommandés ; une carte avec 4 à 8 Go de VRAM améliore le confort |
| 14 milliards de paramètres | Réponses plus nuancées et tâches plus longues | Machine mieux équipée, avec une mémoire disponible importante |
| 70 milliards de paramètres | Expérimentation avancée | Matériel haut de gamme ou mémoire unifiée très généreuse |
La quantification réduit la précision numérique des poids du modèle pour diminuer sa taille et son besoin en mémoire. Un fichier GGUF quantifié est donc plus accessible qu’une version en pleine précision. Pour un modèle de 7 milliards de paramètres, comptez souvent 4 à 8 Go sur le disque selon la quantification ; les fichiers peuvent aller d’environ 3 Go à plus de 40 Go. Commencez léger : un modèle qui répond vite est plus utile qu’un modèle trop grand qui bloque la machine.
Imaginez la mémoire comme un espace de travail partagé. Le système d’exploitation en utilise une partie, l’application réserve la sienne, le modèle charge ses poids, puis chaque longue conversation ajoute un contexte à maintenir. Un modèle qui tient tout juste en RAM peut donc ralentir lorsque vous ouvrez un navigateur, chargez un PDF ou prolongez l’échange. Garder une marge de mémoire, réduire la longueur du contexte et fermer les logiciels lourds sont souvent plus efficaces que de choisir immédiatement un modèle plus puissant.
Installer et lancer un premier modèle sans se perdre
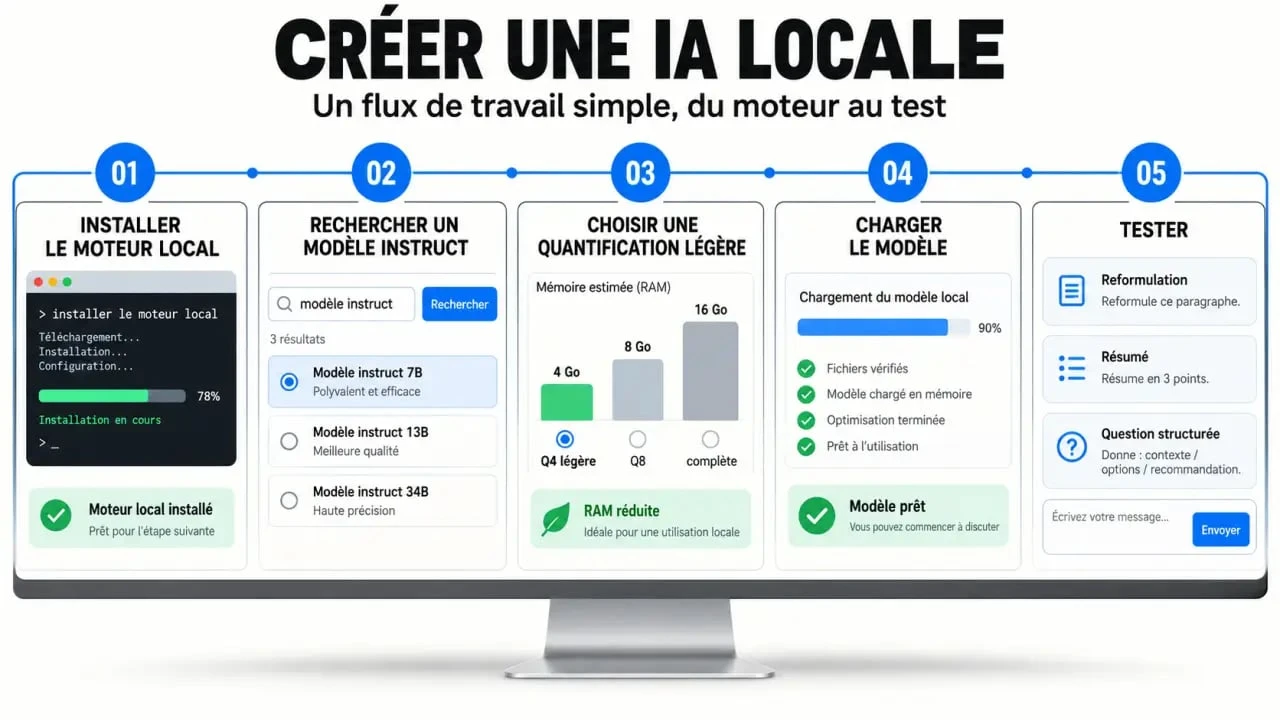
Une interface graphique permet d’effectuer le premier essai en quelques étapes. Le principe reste le même avec les autres outils : installer le moteur, sélectionner un modèle compatible, le charger, puis échanger avec lui.
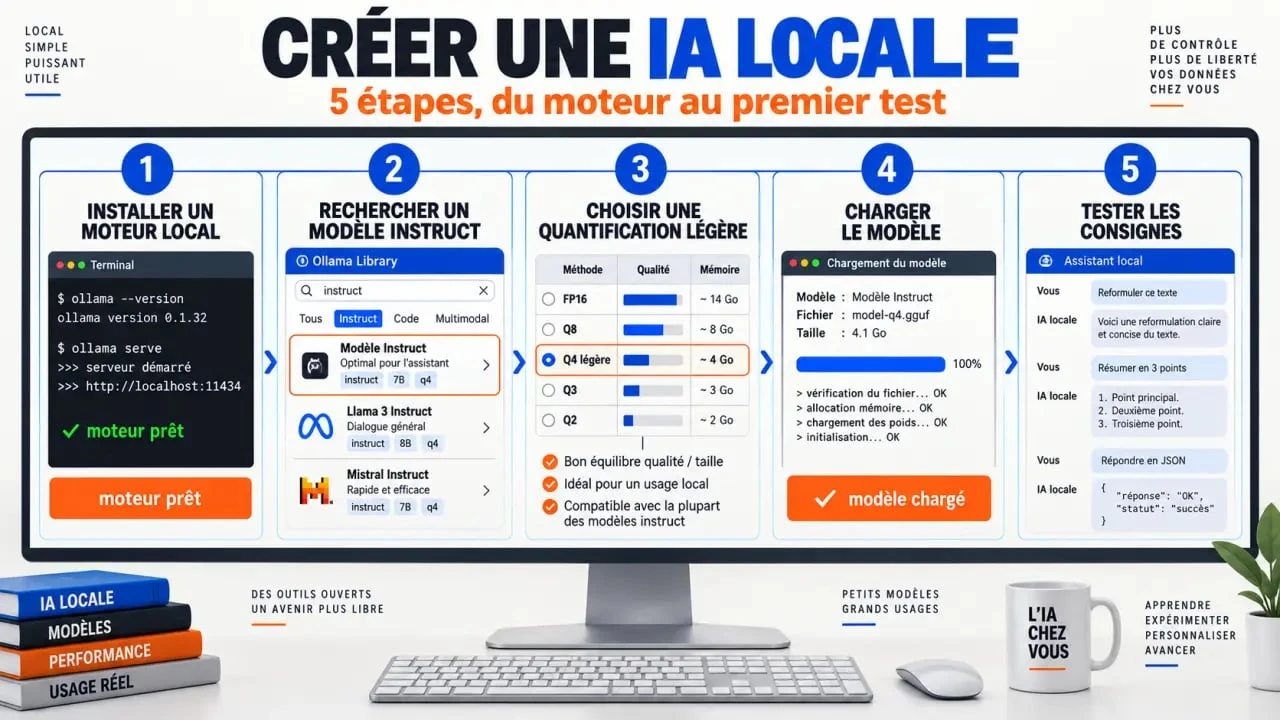
- Installez LM Studio depuis son site officiel et ouvrez l’application.
- Recherchez un modèle instruct, c’est-à-dire entraîné pour répondre à des consignes. Sur une machine standard, commencez par une variante de petite taille ou un modèle autour de 7B quantifié.
- Choisissez une quantification raisonnable en vérifiant le poids du fichier et la mémoire disponible. Ne téléchargez pas le plus gros fichier par défaut.
- Chargez le modèle dans l’onglet de discussion, puis attendez la fin de son initialisation.
- Testez trois demandes concrètes : une reformulation, un résumé et une question nécessitant une réponse structurée. Vous pourrez ainsi évaluer la vitesse, la qualité du français et la pertinence.
Si le chargement échoue, réduisez d’abord la taille du modèle ou choisissez une quantification plus légère, puis fermez les applications gourmandes. Si la réponse est lente alors que le modèle démarre, réduisez la longueur du contexte et essayez un modèle plus petit. Un diagnostic matériel avec canirun.ai ou llmfit peut aider à estimer les modèles adaptés avant de remplir inutilement le disque.
Passer du chat aux documents, sans surestimer le résultat
Une IA locale devient particulièrement utile lorsqu’elle travaille sur vos propres fichiers : notes TXT, tableaux CSV, documents DOCX ou PDF. Les fonctions d’analyse découpent généralement le contenu, recherchent les passages pertinents, puis les transmettent au modèle avec votre question. Cette méthode est souvent appelée RAG : le modèle ne mémorise pas nécessairement le document et s’appuie sur des extraits récupérés au moment de répondre.
Des usages concrets et prudents
- Résumer un compte rendu, puis demander une liste d’actions avec responsables et échéances.
- Comparer plusieurs versions d’un texte sans exposer leur contenu à un assistant cloud.
- Interroger une documentation technique locale et obtenir des explications adaptées à votre niveau.
- Préparer un brouillon d’e-mail ou une trame de réunion avant relecture humaine.
Pour obtenir des résultats plus fiables, utilisez une consigne délimitée : « Réponds uniquement à partir du document, cite le passage utilisé et indique “information absente” si nécessaire. » Vérifiez aussi que l’option de recherche web ou le fournisseur distant n’est pas activé. Une IA locale offre un espace de travail privé, mais ses performances restent liées au matériel, à la qualité du modèle et à la clarté des documents que vous lui confiez.